Smart Document Crawler
Innerhalb von Smart Document Access können Sie den Crawler konfigurieren, um die Inhalte einer Website zu indizieren.
Der Crawler arbeitet in drei getrennten Phasen: einer ersten Phase der Link-Navigation, die die Struktur der Website erfasst, einer zweiten Phase der Inhaltsextraktion, die die nützlichen Inhalte identifiziert, und einer dritten Phase der PDF-Konvertierung, die die indizierten Dokumente erzeugt.
1. Link-Navigation
Der Crawler folgt den internen Links der Website und erfasst ihre Struktur, ohne Inhalte zu extrahieren.
2. Inhaltsextraktion
Die besuchten Seiten werden analysiert, um die nützlichen Inhalte zu identifizieren.
3. PDF-Konvertierung
Die extrahierten Inhalte werden in indizierte PDF-Dokumente umgewandelt. Enthält eine Seite keine extrahierbaren Inhalte, wird kein Dokument erzeugt.
Aktivierung und Erstellung der Struktur
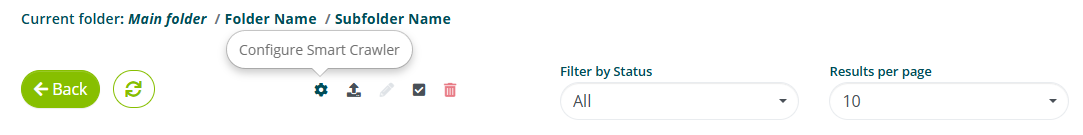
Wählen Sie in einem bereits erstellten Unterordner die Option Smart Crawler konfigurieren.
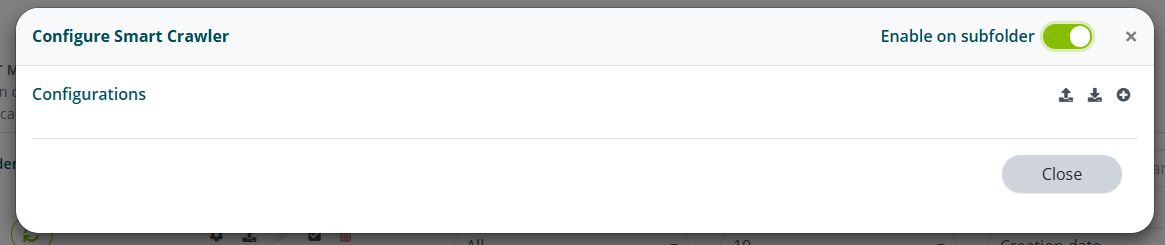
Aktivieren Sie den Schalter Im Unterordner aktivieren.
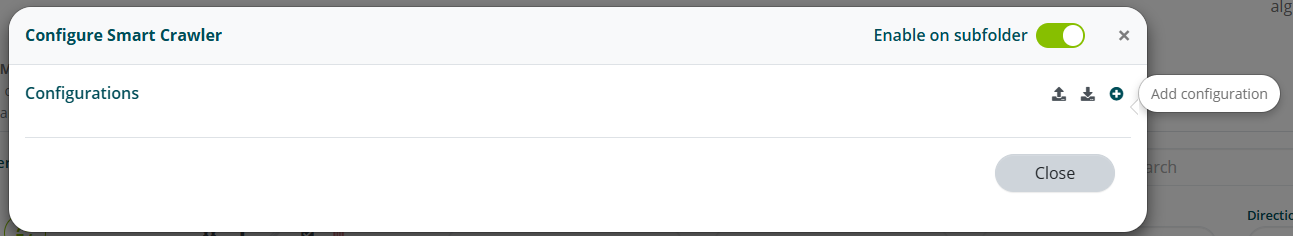
Wählen Sie Konfiguration hinzufügen.
Weisen Sie der Konfiguration einen Namen zu und wählen Sie Speichern.
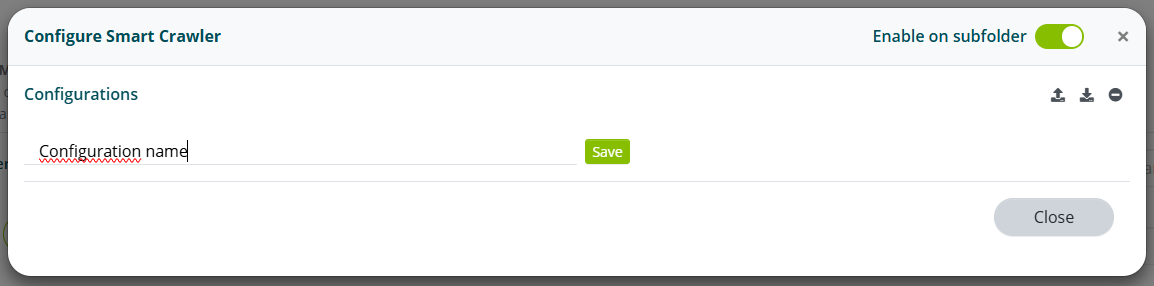
In dieser Phase können Sie zuvor heruntergeladene Konfigurationen importieren oder die bereits vorhandenen herunterladen.
Crawler einrichten
Über Felder bearbeiten gelangen Sie zur Konfiguration des Crawlers.
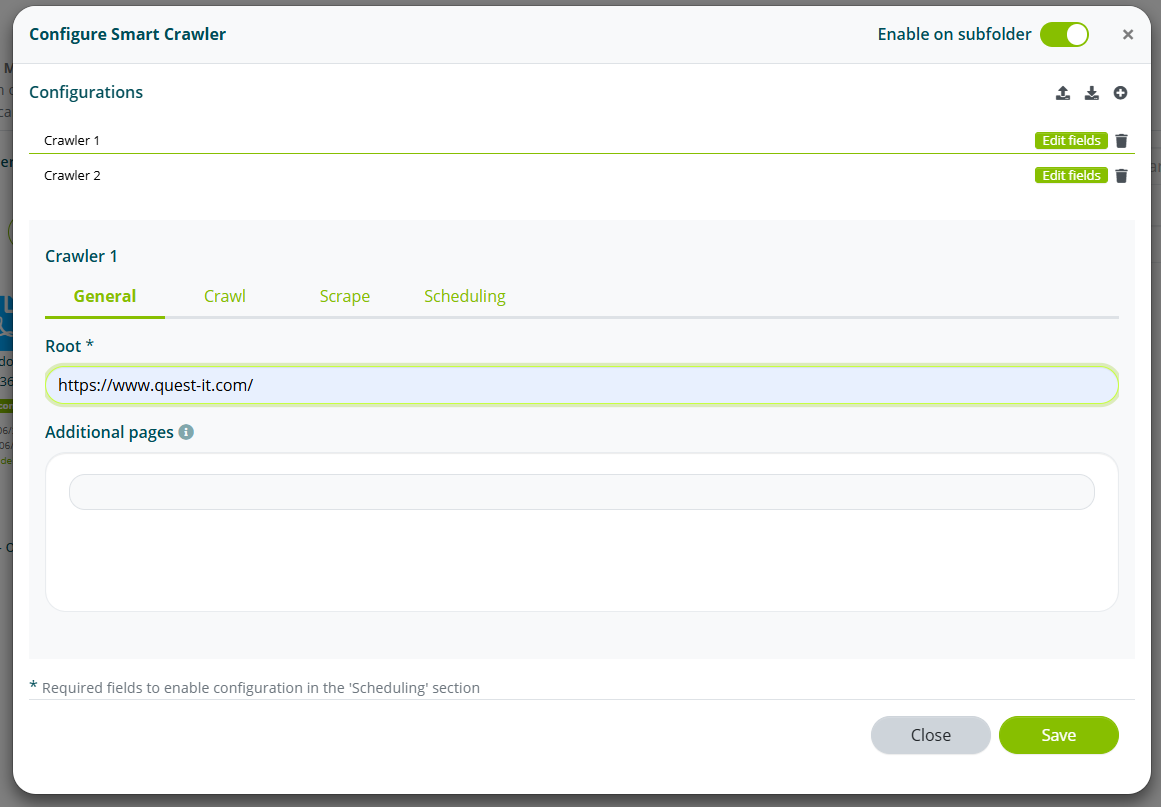
Allgemein
Im Bereich Allgemein legen Sie die URLs fest, von denen der Crawler startet.
Geben Sie die Start-URL der Website in das Feld Adresse ein.
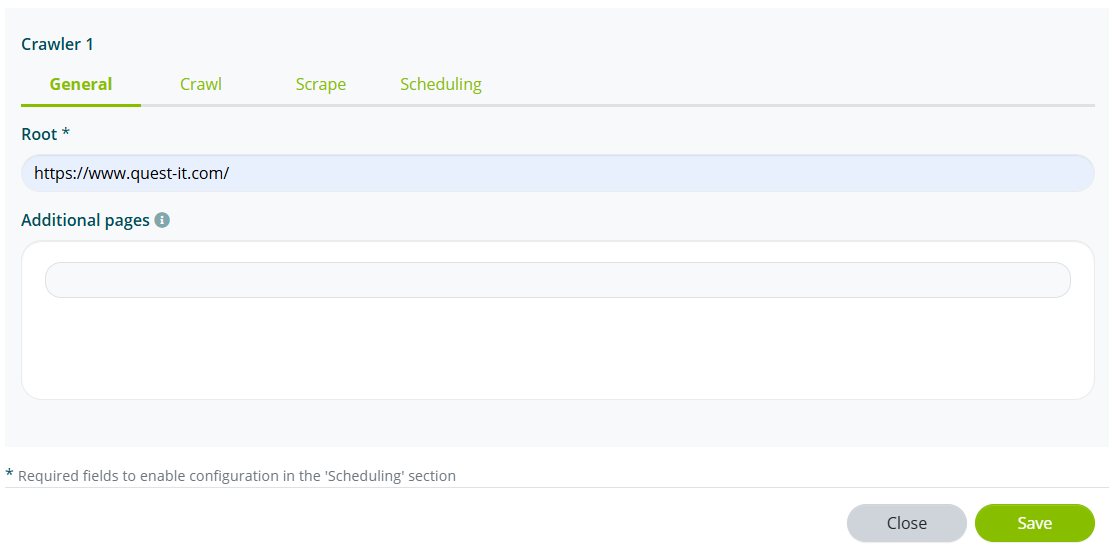
Im Feld Zusätzliche Seiten können Sie weitere Start-URLs eingeben:
- Eine einzige URL: Der Crawler startet von dieser URL und wendet die Einstellungen der Bereiche Navigation und Extraktion an.
- Mehrere URLs: Der Crawler startet von jeder der angegebenen URLs und wendet auf jede dieselben Navigations- und Extraktionseinstellungen an.
Wenn nur wenige, bekannte Seiten extrahiert werden sollen, kann es sinnvoll sein, diese direkt als Start-URLs einzugeben, anstatt von der Sitemap, der Startseite oder von Übersichtsseiten auszugehen, die sie auflisten.
Navigation
Im Bereich Navigation geben Sie an, welche Seiten der Crawler besuchen soll, um die darin enthaltenen Links zu sammeln.
Der Crawler startet von den im Bereich Allgemein festgelegten URLs und sammelt deren Links. Von den gefundenen Links besucht er nur die Seiten, die den Einzuschließenden Adressen entsprechen, und sammelt wiederum deren Links. Der Vorgang wiederholt sich Ebene für Ebene bis zur eingestellten maximalen Tiefe.
Auch die Start-URLs müssen in den Einzuschließenden Adressen enthalten sein: Andernfalls startet der Crawler zwar, navigiert aber nicht einmal die Startseite und sammelt keine Links.
Eine Seite ist also nur dann erreichbar, wenn ihr Link auf einer Seite erscheint, die der Crawler navigiert hat. Ebenso kann eine Seite in der Phase der Extraktion nur dann in ein PDF umgewandelt werden, wenn ihre URL während der Navigation gesammelt wurde.
Beispiel — Seitenhierarchie:
beispiel.com/sitemap                       ← Start-URL
└── beispiel.com/products                  ← Kindseite: in der Sitemap verlinkt
    └── beispiel.com/products/algho        ← Enkelseite: nur in /products verlinkt
Sie möchten die Seite beispiel.com/products/algho extrahieren, die nicht in der Sitemap erscheint, sondern nur auf der Seite beispiel.com/products verlinkt ist:
- Enthalten die Einzuschließenden Adressen nur
https://beispiel.com/sitemapundhttps://beispiel.com/products/algho, erreicht der Crawler die Seite nie: In der Sitemap findet er zwar den Link zu/products, navigiert diese Seite aber nicht und sammelt daher auch nicht ihre Links. - Enthalten die Einzuschließenden Adressen zusätzlich
https://beispiel.com/products, navigiert der Crawler/products, sammelt den Link zu/products/alghound die Seite steht für die Extraktion zur Verfügung.
Alternativ können beispiel.com/products oder beispiel.com/products/algho direkt unter Zusätzliche Seiten im Bereich Allgemein eingegeben werden. Denken Sie daran, sie auch zu den Einzuschließenden Adressen hinzuzufügen.
Aktivieren Sie die Option Off-Site-Domains ausschließen, um die Navigation auf Links innerhalb der Hauptdomain zu beschränken.
Aktivieren Sie die Option PDF-, Doc-, Docx-Dokumente einschließen, wenn auch die an Webseiten angehängten Dokumente navigiert werden sollen.
Geben Sie im Feld Einzuschließende Adressen die Liste der zu navigierenden Seiten der Website ein.
Geben Sie im Feld Auszuschließende Adressen die Liste der Seiten der Website ein, die nicht navigiert werden sollen.
Beide Felder akzeptieren reguläre Ausdrücke (Regex), um URL-Muster zu definieren. Vor dem Erstellen der Regex ist es hilfreich, die Pfadstruktur der Website zu analysieren: Die Pfadsegmente zeigen die Kategorisierung der Seiten.
Beispiel — Struktur einer Website:
beispiel.com/use-cases
beispiel.com/products/algho
beispiel.com/products/sda
beispiel.com/products/booking
beispiel.com/products/pricing
beispiel.com/blog/first-post
beispiel.com/docs/getting-started
beispiel.com/docs/getting-started-api
beispiel.com/about
beispiel.com/contact
Wichtigste Mustertypen:
| Muster | Beispiel | Übereinstimmende URLs |
|---|---|---|
| Exakte Übereinstimmung | https://beispiel.com/use-cases | https://beispiel.com/use-cases |
| Alternation | https://beispiel.com/products/((algho)|(sda)|(booking)) | beispiel.com/products/algho, beispiel.com/products/sda, beispiel.com/products/booking |
Wildcard mit .* | https://beispiel.com/products/.* | beispiel.com/products/algho, beispiel.com/products/sda, beispiel.com/products/booking, beispiel.com/products/pricing |
| Gemeinsames Präfix | https://beispiel.com/docs/getting-.* | beispiel.com/docs/getting-started, beispiel.com/docs/getting-started-api |
Jede Regex folgt dem Schema: https://[Domain]/[Segment1]/[Segment2]/...
| Komponente | Bedeutung |
|---|---|
https:// | HTTP- oder HTTPS-Protokoll |
Domain | Domainname |
.* | Beliebiger Text (generische Wildcard) |
(a|b|c) | Alternation: eines von a, b oder c |
Eine Regex sollte an der Gesamtheit der URLs der Website getestet werden, nicht nur an den bekannten Seiten. So werden Falsch-Positive sichtbar: unerwünschte Seiten, die die Regex trotzdem erfasst.
Zum Beispiel erfasst https://beispiel.com/products/.* sowohl products/algho (gewünscht) als auch products/pricing (Falsch-Positiv). Wenn pricing nicht gewünscht ist, ist das Muster mit Alternation vorzuziehen.
Grundsätze für die Wahl der besten Regex:
- Einfachheit bevorzugen: Eine kurze, gut lesbare Regex ist besser als eine komplexe.
- Immer am gesamten Crawl testen: Eine Regex, die nur bei den bekannten Seiten funktioniert, ist nicht zuverlässig.
- Zu generische Regex vermeiden:
https?://.*erfasst die gesamte Website, was nicht sinnvoll ist. - Künftiges Wachstum berücksichtigen: Eine Wildcard auf einer Kategorie erfasst auch Seiten, die nach der Definition der Regel hinzugefügt werden.
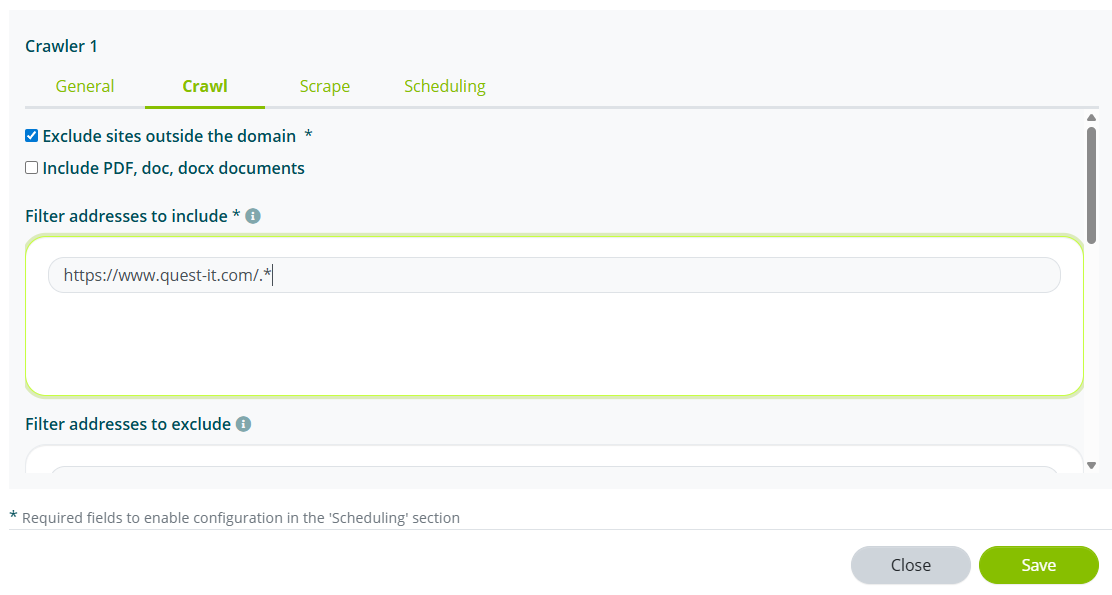
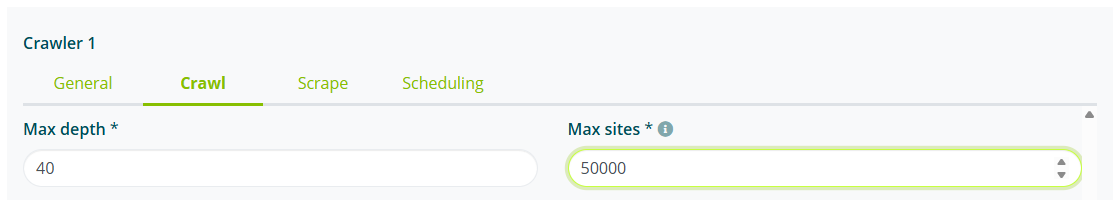
Legen Sie die maximale Tiefe und die maximale Anzahl von Seiten für die Navigation fest.
Extraktion
Im Bereich Extraktion konfigurieren Sie die Regeln, nach denen der Crawler die Webseiten in Dokumentation umwandelt.
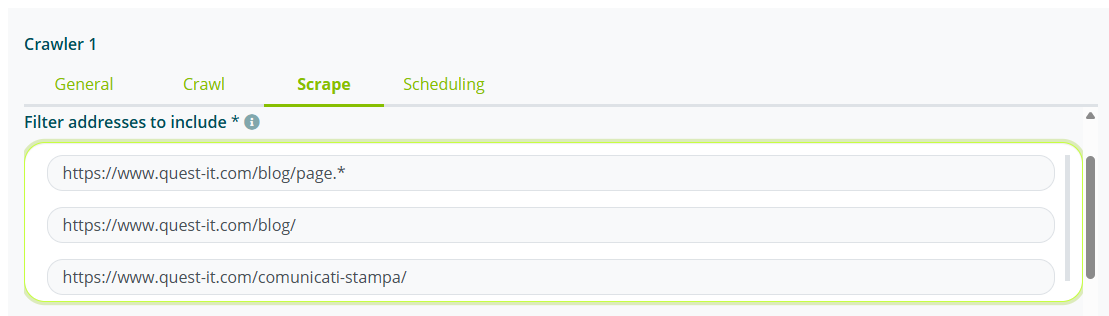
Geben Sie im Feld Filteradressen zum Einschließen die Liste der Seiten ein, die extrahiert und in Dokumentation umgewandelt werden sollen.
Beide Felder akzeptieren dieselben regulären Ausdrücke, die im Bereich Navigation beschrieben sind. Die zu extrahierenden Seiten können mit den zu navigierenden Seiten übereinstimmen oder eine bestimmte Teilmenge davon bilden.
Eine Seite kann nur extrahiert werden, wenn ihre URL während der Navigationsphase gesammelt wurde. Stellen Sie sicher, dass die Einzuschließenden Adressen im Bereich Navigation alle relevanten Seiten abdecken.
Geben Sie im Feld Filteradressen zum Ausschließen die Liste der Seiten ein, die nicht extrahiert werden sollen.
Elemente von der Seite entfernen
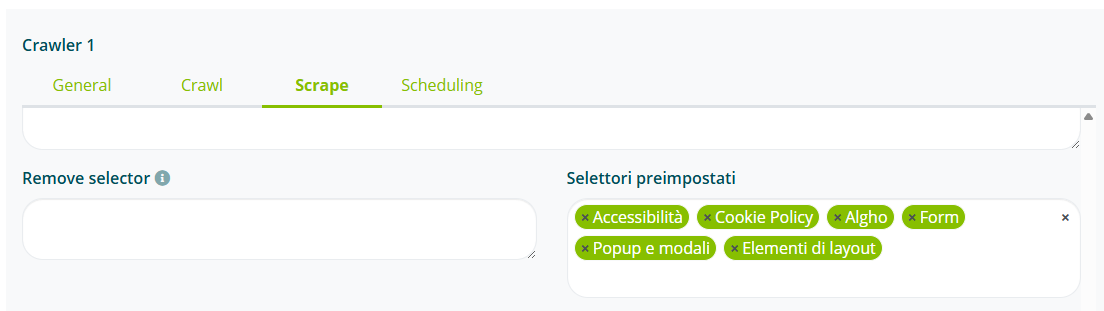
Bevor eine Seite in ein PDF umgewandelt wird, führt der Crawler bereits eine grundlegende Bereinigung der Inhalte durch. Jede Website ist jedoch anders aufgebaut und kann Elemente enthalten, die für die Dokumentation nicht nützlich sind, etwa Menüs, Banner, Footer oder Cookie-Hinweise. Das Feld Elemente entfernen ermöglicht eine gezieltere Bereinigung: Die angegebenen Elemente werden vor der Erzeugung des PDFs von der Seite entfernt.
Das Feld bietet einige voreingestellte Selektoren und akzeptiert auch manuell eingegebene Selektoren im CSS-, XPATH- oder Puppeteer-kompatiblen Format.
Die gebräuchlichsten CSS-Selektoren sind:
| Typ | Syntax | Beispiel | Entfernte Elemente |
|---|---|---|---|
| Klasse | . + Klassenname | .cookie-banner | Alle Elemente mit class="cookie-banner" |
| ID | # + ID | #newsletter | Das Element mit id="newsletter" |
| HTML-Element | Name des Elements | header, footer, nav | Alle Elemente dieses Typs |
Um die zu entfernenden Klassen und IDs zu ermitteln, öffnen Sie die Seite im Browser, klicken Sie mit der rechten Maustaste auf das Element und wählen Sie Untersuchen: Der hervorgehobene HTML-Code zeigt die Attribute class und id des Elements.
Hat ein Element mehrere Klassen, genügt es, eine davon anzugeben. Für ein Menü mit class="sidebar menu-laterale" reicht zum Beispiel der Selektor .menu-laterale.
Die Entfernung gilt für alle vom Crawler extrahierten Seiten. Daher empfiehlt es sich, vor allem Elemente anzugeben, die auf der gesamten Website vorkommen: Erscheint ein Seitenmenü mit der Klasse .menu-laterale auf jeder Seite, genügt es, den Selektor einmal einzugeben, um es überall zu entfernen. Elemente, die nur auf einzelnen Seiten vorkommen, müssen dagegen einzeln ermittelt und hinzugefügt werden.
Vermeiden Sie zu generische Selektoren wie div: Ein so häufiges Element kommt fast überall auf der Seite vor, und seine Entfernung würde auch die zu extrahierenden Inhalte löschen.
Der Crawler führt bereits eine Vorbereinigung der Seite durch: Die manuelle Angabe der zu entfernenden Elemente ist nicht verpflichtend, wird aber vor allem für ältere Websites oder solche mit besonderen Layouts empfohlen.
Zeitplanung
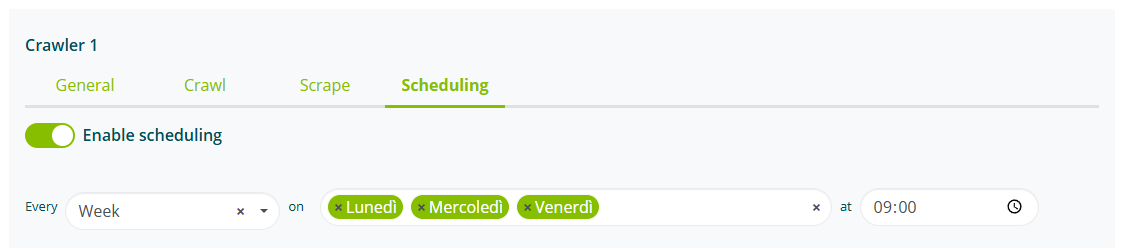
Wählen Sie Zeitplanung aktivieren, legen Sie die Ausführungshäufigkeit des Crawlers fest (wöchentlich oder monatlich) und stellen Sie den Starttag und die Startzeit ein; für die wiederholte Ausführung können mehrere Wochen- oder Monatstage festgelegt werden.
Dokumente anzeigen
Um die vom Crawler erzeugten PDF-Dokumente zu überprüfen, kehren Sie zum Unterordner in Smart Document Access zurück.
Die Liste der indizierten Dokumente steht im Bereich des konfigurierten Unterordners zur Verfügung.
Jedem Dokument ist als Quelldatei die URL zugeordnet, aus der es erzeugt wurde.