Smart Document Crawler
All'interno di Smart Document Access, è possibile configurare il crawler per l'indicizzazione dei contenuti di un sito web.
Il crawler opera in tre fasi distinte: una prima fase di navigazione dei link, che mappa la struttura del sito, una seconda fase di estrazione dei contenuti, che identifica i contenuti utili, e una terza fase di conversione in PDF, che genera i documenti indicizzati.
1. Navigazione dei link
Il crawler segue i link interni del sito e ne mappa la struttura, senza estrarre contenuti.
2. Estrazione dei contenuti
Le pagine navigate vengono analizzate per identificare i contenuti utili.
3. Conversione in PDF
I contenuti estratti vengono convertiti in documenti PDF indicizzati. Se una pagina non contiene contenuti estraibili, non viene generato alcun documento.
Attivazione e creazione della struttura
All'interno di una sottocartella già creata, selezionare l'opzione Configura Smart Crawler.
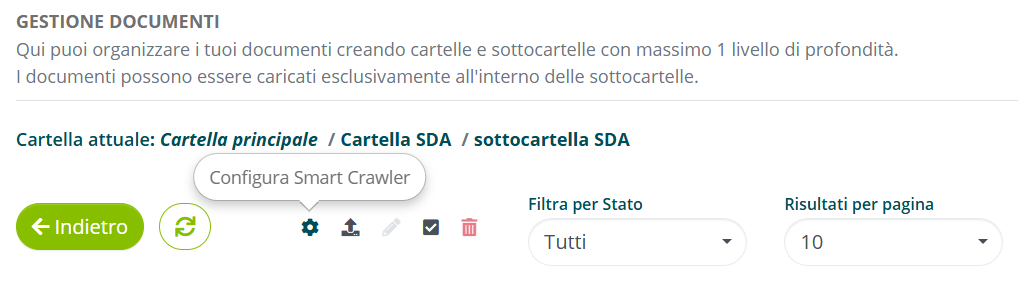
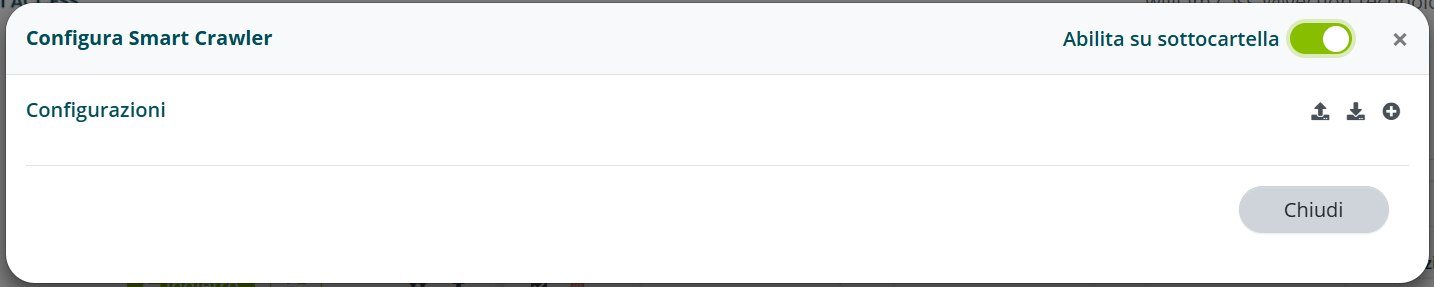
Attivare la spunta Abilita su sottocartella
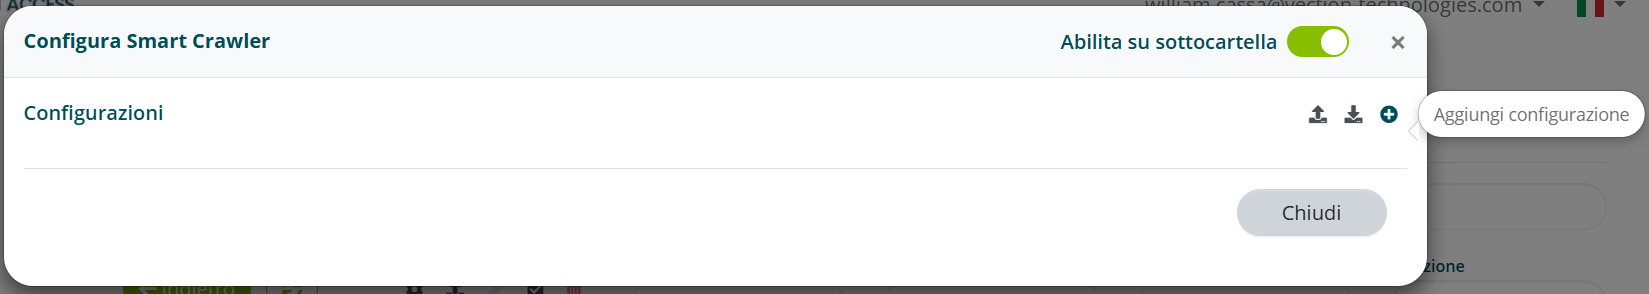
Selezionare Aggiungi configurazione
Assegnare un nome alla configurazione e selezionare Salva.
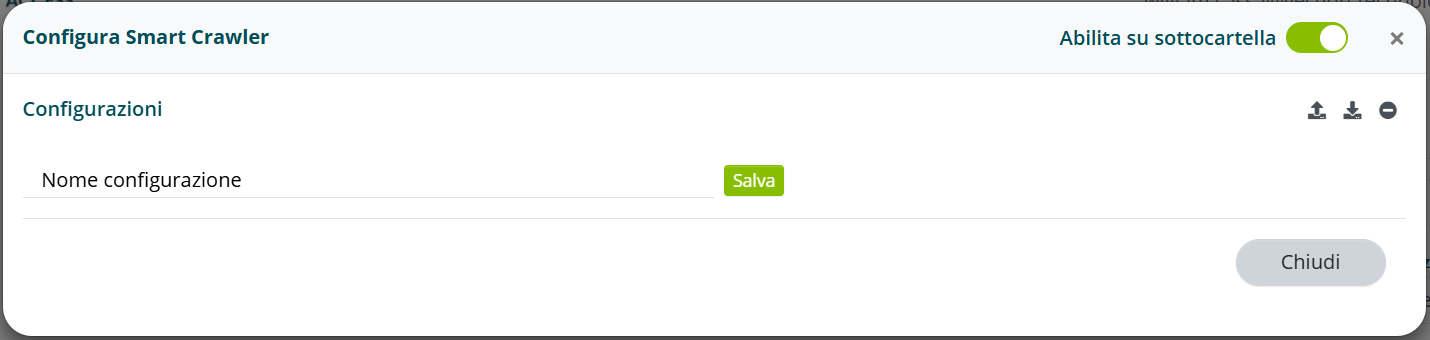
In questa fase è possibile importare configurazioni precedentemente scaricate oppure scaricare quelle già presenti.
Impostare il Crawler
Selezionando Modifica campi si accede alla configurazione del Crawler.
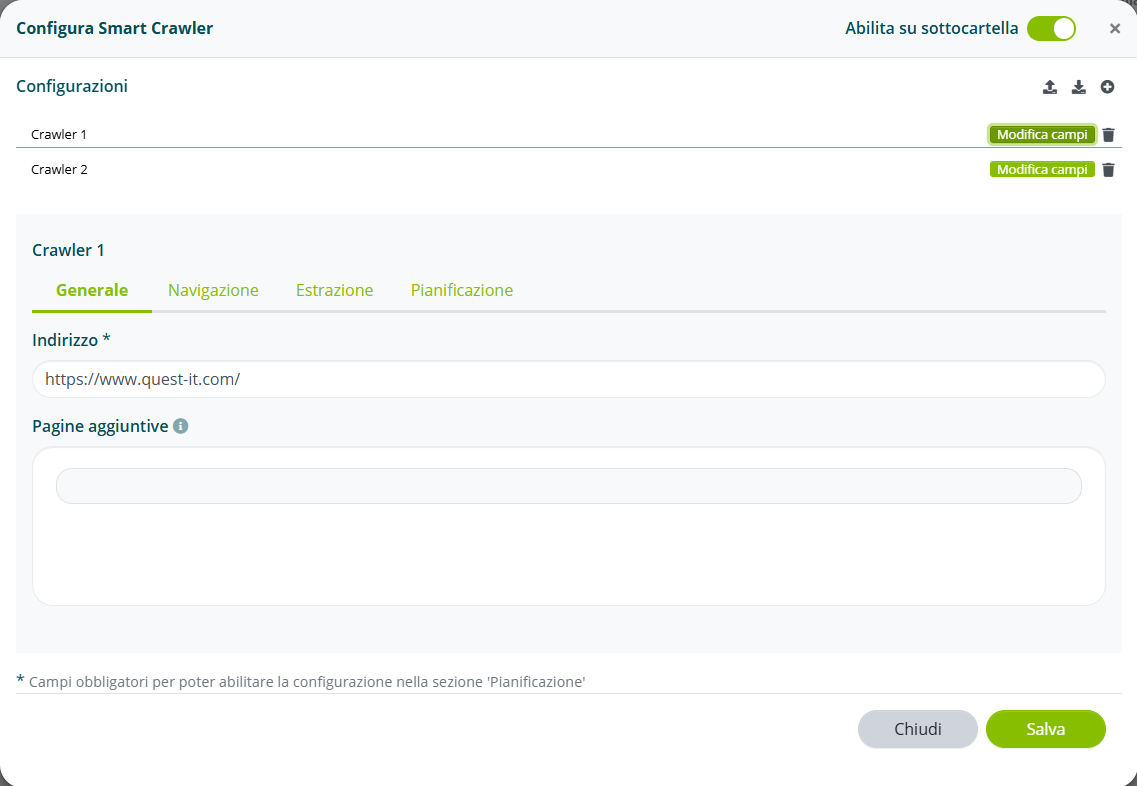
Generale
Nella sezione Generale si definiscono gli URL da cui parte il crawler.
Inserire l'URL di partenza del sito nel campo Indirizzo.
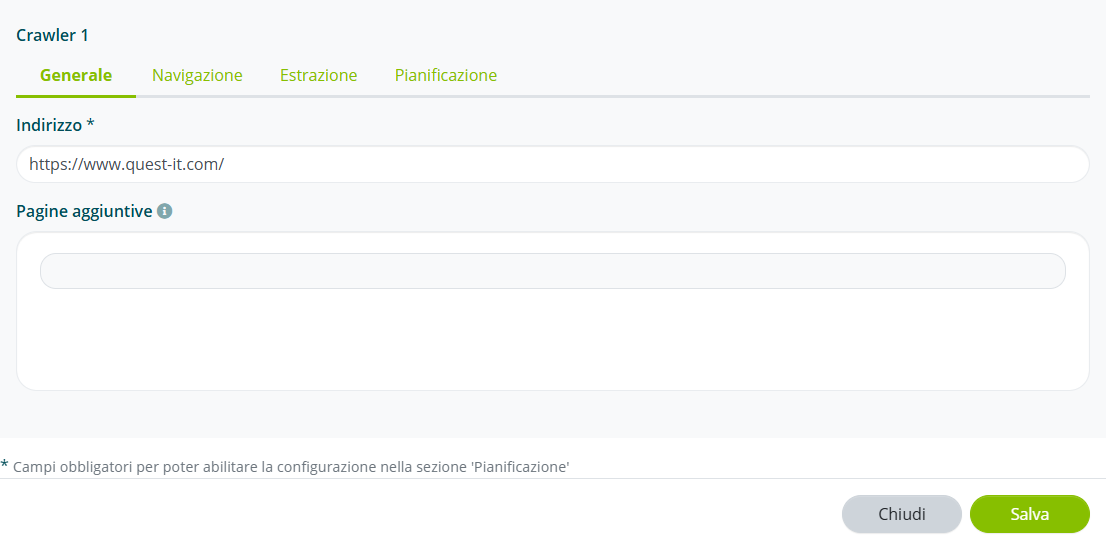
Nel campo Pagine aggiuntive è possibile inserire altri URL di partenza:
- Un solo URL: il crawler parte da quell'URL e applica le impostazioni di Navigazione ed Estrazione.
- Più URL: il crawler parte da ciascuno degli URL indicati e applica a ognuno le stesse impostazioni di navigazione ed estrazione.
Quando le pagine da estrarre sono poche e note, può essere utile inserirle direttamente come URL di partenza, invece di partire dalla sitemap, dalla home page o da pagine contenitore che le elencano.
Navigazione
Nella sezione Navigazione si indica al crawler quali pagine visitare per raccogliere i link al loro interno.
Il crawler parte dagli URL definiti nella sezione Generale e ne raccoglie i link. Tra i link trovati, visita solo le pagine che corrispondono agli Indirizzi da includere e, a loro volta, ne raccoglie i link. Il processo si ripete livello per livello, fino alla profondità massima impostata.
Anche gli URL di partenza devono comparire negli Indirizzi da includere: in caso contrario il crawler parte, ma non naviga nemmeno la pagina di partenza e non raccoglie alcun link.
Una pagina diventa quindi raggiungibile solo se il suo link compare in una pagina che il crawler ha navigato. Allo stesso modo, una pagina può essere convertita in PDF nella fase di Estrazione solo se il suo URL è stato raccolto durante la navigazione.
Esempio — gerarchia delle pagine:
dominio.com/sitemap                       ← URL di partenza
└── dominio.com/products                  ← figlia: linkata nella sitemap
    └── dominio.com/products/algho        ← nipote: linkata solo in /products
Si vuole estrarre la pagina dominio.com/products/algho, che non compare nella sitemap ma è linkata solo nella pagina dominio.com/products:
- Se gli Indirizzi da includere contengono solo
https://dominio.com/sitemapehttps://dominio.com/products/algho, il crawler non raggiunge mai la pagina: dalla sitemap trova il link a/products, ma non lo naviga e quindi non ne raccoglie i link. - Se gli Indirizzi da includere contengono anche
https://dominio.com/products, il crawler naviga/products, raccoglie il link a/products/alghoe la pagina diventa disponibile per l'estrazione.
In alternativa, dominio.com/products o dominio.com/products/algho possono essere inseriti direttamente tra le Pagine aggiuntive della sezione Generale, ricordando di aggiungerli anche agli Indirizzi da includere.
Abilitare l'opzione Escludi i siti fuori dal dominio per limitare la navigazione ai soli link interni al dominio principale.
Abilitare l'opzione Includi documenti PDF, doc, docx se si vogliono navigare anche i documenti allegati alle pagine web.
Nel campo Indirizzi da includere inserire l'elenco delle pagine del sito da navigare.
Nel campo Indirizzi da escludere inserire l'elenco delle pagine del sito da non navigare.
Entrambi i campi accettano espressioni regolari (regex) per definire pattern di URL. Prima di creare le regex, è utile analizzare la struttura dei path del sito: i segmenti del path rivelano la categorizzazione delle pagine.
Esempio — struttura di un sito:
dominio.com/use-cases
dominio.com/products/algho
dominio.com/products/sda
dominio.com/products/booking
dominio.com/products/pricing
dominio.com/blog/first-post
dominio.com/docs/getting-started
dominio.com/docs/getting-started-api
dominio.com/about
dominio.com/contact
Tipi di pattern principali:
| Pattern | Esempio | URL match |
|---|---|---|
| Corrispondenza esatta | https://dominio.com/use-cases | https://dominio.com/use-cases |
| Alternazione | https://dominio.com/products/((algho)|(sda)|(booking)) | dominio.com/products/algho, dominio.com/products/sda, dominio.com/products/booking |
Wildcard con .* | https://dominio.com/products/.* | dominio.com/products/algho, dominio.com/products/sda, dominio.com/products/booking, dominio.com/products/pricing |
| Prefisso condiviso | https://dominio.com/docs/getting-.* | dominio.com/docs/getting-started, dominio.com/docs/getting-started-api |
La struttura di ogni regex segue lo schema: https://[dominio]/[segmento1]/[segmento2]/...
| Componente | Significato |
|---|---|
https:// | Protocollo HTTP o HTTPS |
dominio | Nome di dominio |
.* | Qualsiasi testo (wildcard generica) |
(a|b|c) | Alternazione: uno tra a, b o c |
Una regex va testata sull'intero insieme delle URL del sito, non solo sulle pagine note. Questo rivela i falsi positivi: pagine non desiderate che la regex cattura comunque.
Ad esempio, https://dominio.com/products/.* cattura sia products/algho (desiderato) sia products/pricing (falso positivo). Se pricing non è desiderato, è preferibile il pattern con alternazione.
Principi per scegliere la regex migliore:
- Preferire la semplicità: una regex breve e leggibile è meglio di una complessa.
- Testare sempre sull'intero crawl: una regex che funziona solo sulle pagine note non è affidabile.
- Evitare regex troppo generiche:
https?://.*cattura tutto il sito, che non è utile. - Considerare la crescita futura: una wildcard su una categoria catturerà anche le pagine aggiunte dopo la definizione della regola.
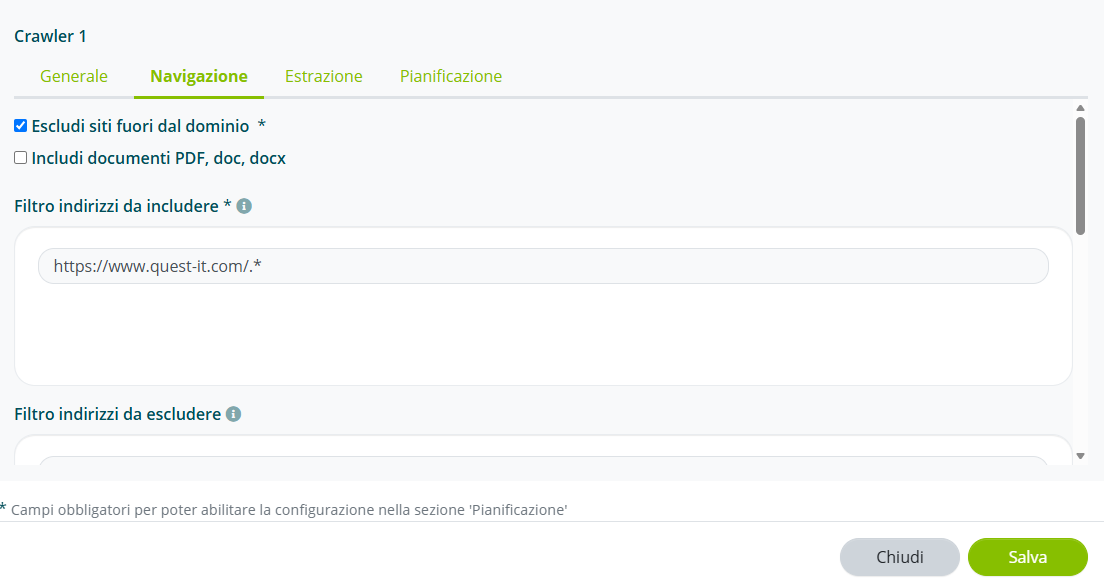
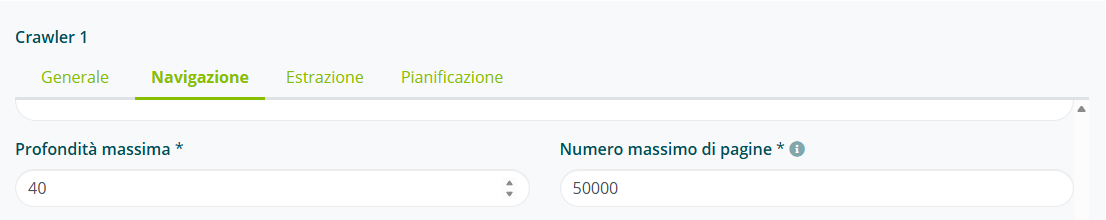
Impostare la profondità massima e il numero massimo di pagine da navigare.
Estrazione
Nella sezione Estrazione vengono configurate le regole che il Crawler seguirà per trasformare le pagine web in documentazione.
Nel campo Filtro indirizzi da includere inserire l'elenco delle pagine da estrarre e convertire in documentazione.
Entrambi i campi accettano le stesse espressioni regolari descritte nella sezione Navigazione. Le pagine da estrarre possono coincidere con le pagine da navigare oppure rappresentare un sottoinsieme specifico.
Una pagina può essere estratta solo se il suo URL è stato raccolto durante la fase di navigazione. Assicurarsi che gli Indirizzi da includere nella sezione Navigazione coprano tutte le pagine di interesse.
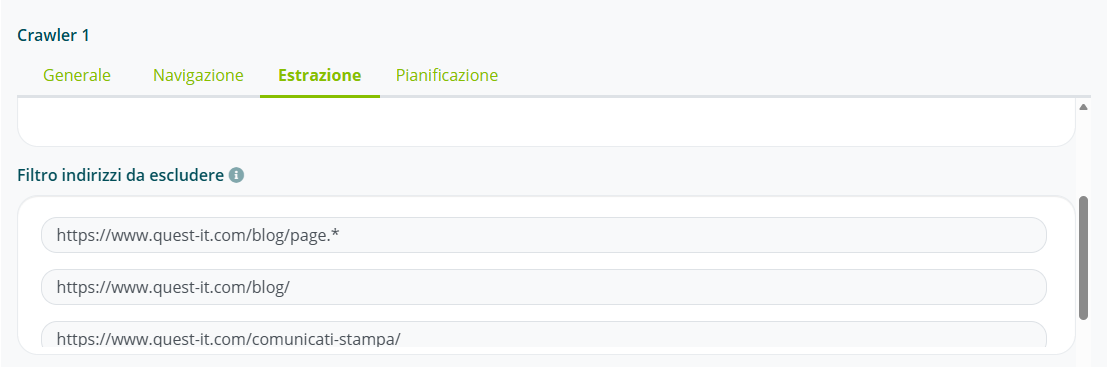
Nel campo Filtro indirizzi da escludere inserire l'elenco delle pagine da non estrarre.
Rimuovere elementi dalla pagina
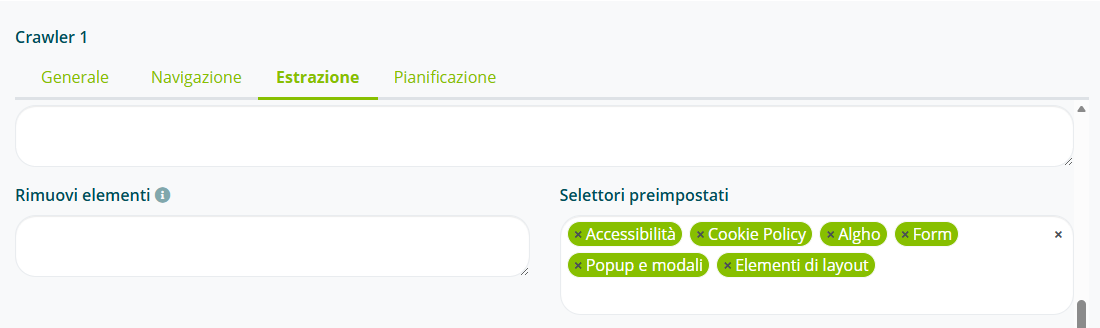
Prima di convertire una pagina in PDF, il crawler esegue già una pulizia di base dei contenuti. Ogni sito però è strutturato in modo diverso e può contenere elementi non utili alla documentazione, come menu, banner, footer o box di cookie. Il campo Rimuovi elementi permette una pulizia più precisa: gli elementi indicati vengono eliminati dalla pagina prima della generazione del PDF.
Il campo propone alcuni selettori preimpostati e accetta anche selettori inseriti manualmente, in formato CSS, XPATH o compatibile con Puppeteer.
I selettori CSS più usati sono:
| Tipo | Sintassi | Esempio | Elementi rimossi |
|---|---|---|---|
| Classe | . + nome della classe | .cookie-banner | Tutti gli elementi con class="cookie-banner" |
| ID | # + id | #newsletter | L'elemento con id="newsletter" |
| Elemento HTML | nome dell'elemento | header, footer, nav | Tutti gli elementi di quel tipo |
Per individuare classi e id da rimuovere, aprire la pagina nel browser, fare clic con il tasto destro sull'elemento e selezionare Ispeziona: il codice HTML evidenziato mostra gli attributi class e id dell'elemento.
Se un elemento ha più classi, basta indicarne una sola. Ad esempio, per un menu con class="sidebar menu-laterale" è sufficiente il selettore .menu-laterale.
La rimozione si applica a tutte le pagine estratte dal crawler. Per questo è buona prassi indicare soprattutto gli elementi comuni a tutto il sito: se un menu laterale identificato dalla classe .menu-laterale compare in ogni pagina, basta inserire il selettore una sola volta per rimuoverlo ovunque. Gli elementi presenti solo in alcune pagine vanno invece individuati e aggiunti singolarmente.
Evitare selettori troppo generici come div: un elemento così comune è presente in quasi tutta la pagina e la sua rimozione eliminerebbe anche i contenuti da estrarre.
Il crawler esegue già una pulizia preliminare della pagina: inserire manualmente gli elementi da rimuovere non è obbligatorio, ma è consigliato soprattutto per siti meno recenti o con layout particolari.
Pianificazione
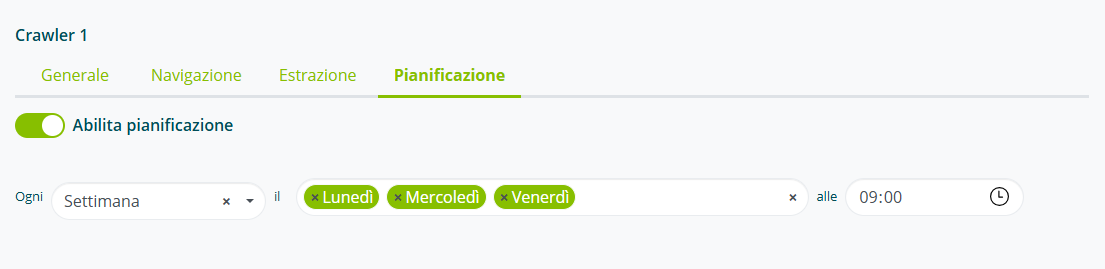
Selezionare Abilita pianificazione e stabilire la frequenza di esecuzione del Crawler (settimanale o mensile) e impostare il giorno e l'ora di partenza; è possibile impostare più giorni della settimana o del mese per l'esecuzione ripetuta.
Visualizzazione dei documenti
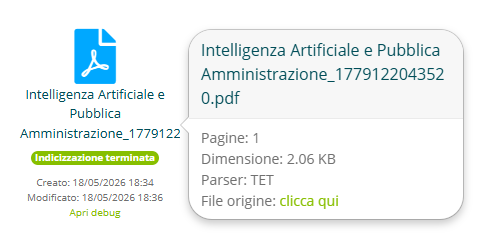
Per verificare i documenti PDF generati dal crawler, tornare all'interno della sottocartella in Smart Document Access.
L'elenco dei documenti indicizzati sarà disponibile nella sezione dedicata alla sottocartella configurata.
Ogni documento ha associato come File origine l'URL da cui è stato generato il documento.