Smart Document Crawler
Dans Smart Document Access, vous pouvez configurer le crawler pour indexer le contenu d'un site web.
Le crawler fonctionne en trois phases distinctes : une première phase de navigation des liens, qui cartographie la structure du site, une seconde phase d'extraction du contenu, qui identifie le contenu utile, et une troisième phase de conversion en PDF, qui génère les documents indexés.
1. Navigation des liens
Le crawler suit les liens internes du site et en cartographie la structure, sans extraire le contenu.
2. Extraction du contenu
Les pages naviguées sont analysées pour identifier le contenu utile.
3. Conversion en PDF
Le contenu extrait est converti en documents PDF indexés. Si une page ne contient pas de contenu extractible, aucun document n'est généré.
Activation et création de la structure
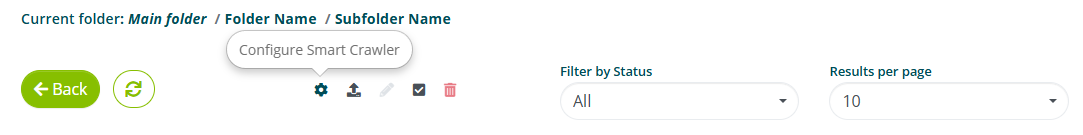
Dans un sous-dossier déjà créé, sélectionnez l'option Configurer Smart Crawler.
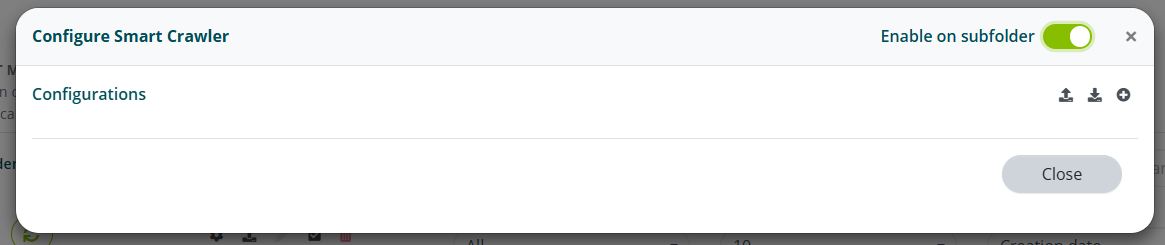
Activez l'option Activer sur le sous-dossier.
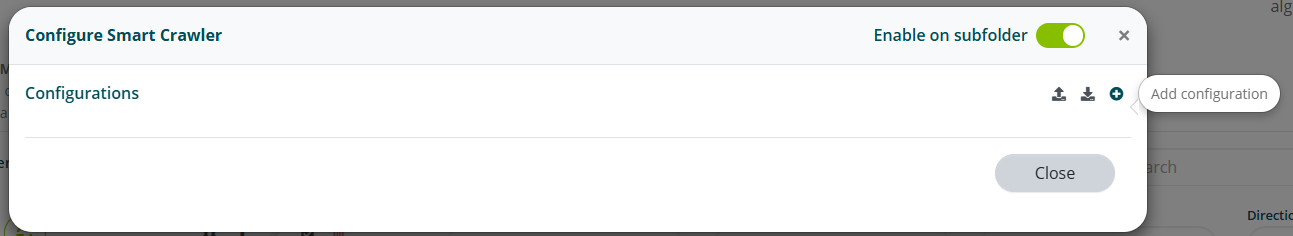
Sélectionnez Ajouter une configuration.
Attribuez un nom à la configuration et sélectionnez Enregistrer.
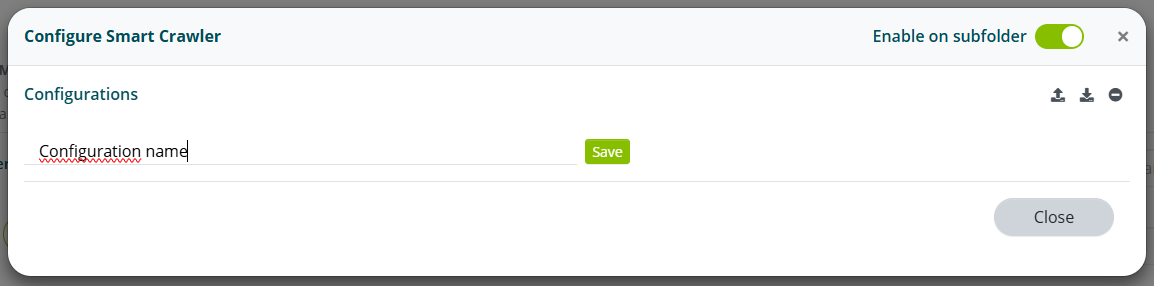
À ce stade, vous pouvez importer des configurations téléchargées précédemment ou télécharger celles déjà existantes.
Configuration du Crawler
Sélectionnez Modifier les champs pour accéder à la configuration du Crawler.
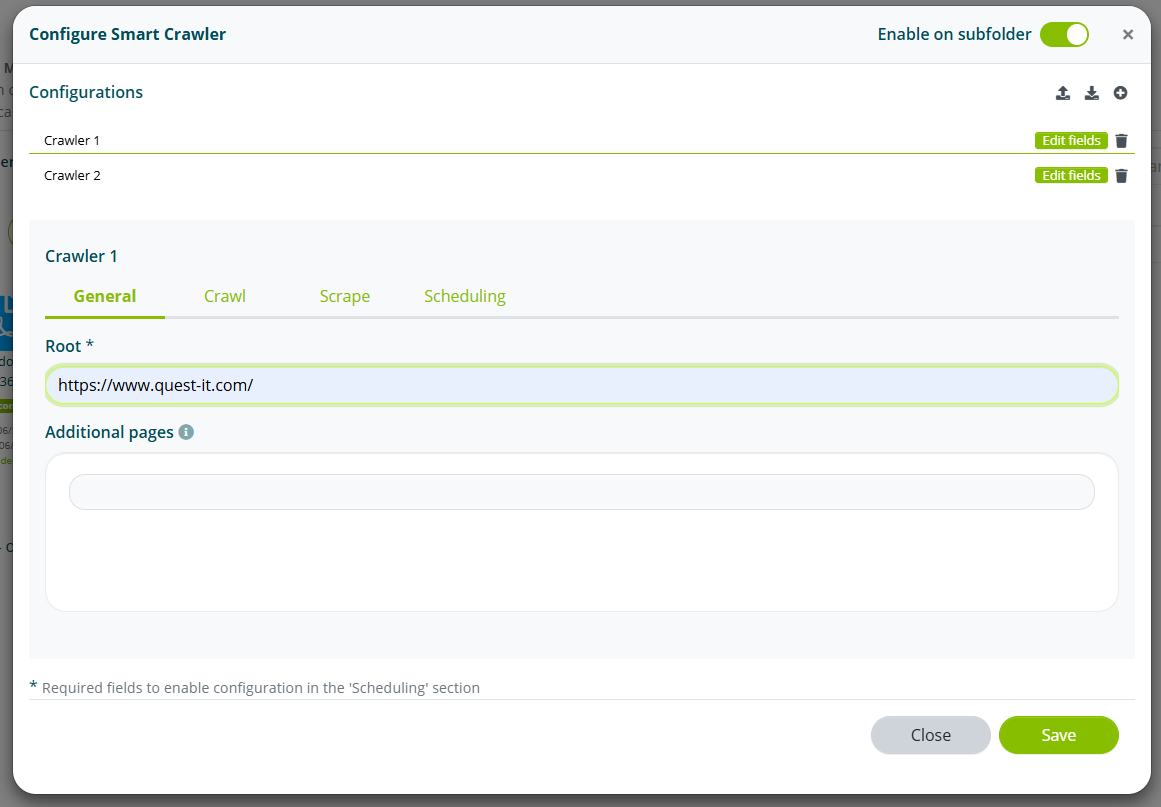
Général
Dans la section Général, vous définissez les URL à partir desquelles le crawler démarre.
Saisissez l'URL de départ du site dans le champ Adresse.
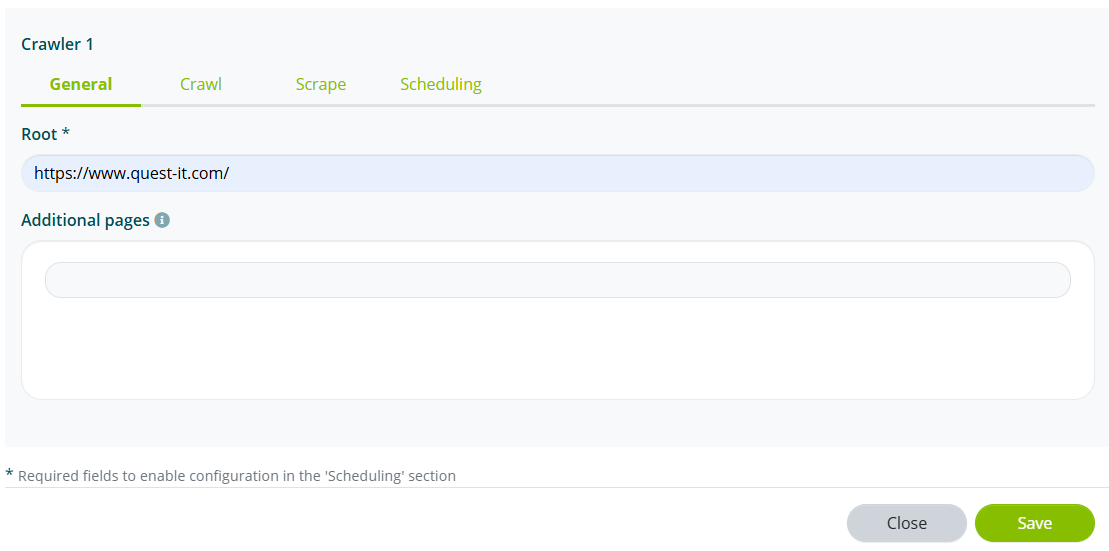
Dans le champ Pages supplémentaires, vous pouvez saisir d'autres URL de départ :
- Une seule URL : le crawler démarre à partir de cette URL et applique les paramètres de Navigation et d'Extraction.
- Plusieurs URL : le crawler démarre à partir de chacune des URL indiquées et applique à chacune les mêmes paramètres de navigation et d'extraction.
Lorsque les pages à extraire sont peu nombreuses et connues, il peut être utile de les saisir directement comme URL de départ, au lieu de partir du sitemap, de la page d'accueil ou de pages conteneurs qui les répertorient.
Navigation
Dans la section Navigation, vous indiquez au crawler quelles pages visiter pour collecter les liens qu'elles contiennent.
Le crawler démarre à partir des URL définies dans la section Général et en collecte les liens. Parmi les liens trouvés, il ne visite que les pages qui correspondent aux Adresses à inclure et, à leur tour, en collecte les liens. Le processus se répète niveau par niveau, jusqu'à la profondeur maximale définie.
Les URL de départ doivent elles aussi figurer dans les Adresses à inclure : dans le cas contraire, le crawler démarre, mais ne navigue même pas la page de départ et ne collecte aucun lien.
Une page ne devient donc accessible que si son lien apparaît dans une page que le crawler a naviguée. De même, une page ne peut être convertie en PDF lors de la phase d'Extraction que si son URL a été collectée pendant la navigation.
Exemple — hiérarchie des pages :
exemple.com/sitemap                       ← URL de départ
└── exemple.com/products                  ← enfant : liée dans le sitemap
    └── exemple.com/products/algho        ← petite-fille : liée uniquement dans /products
Vous souhaitez extraire la page exemple.com/products/algho, qui n'apparaît pas dans le sitemap mais est liée uniquement dans la page exemple.com/products :
- Si les Adresses à inclure contiennent uniquement
https://exemple.com/sitemapethttps://exemple.com/products/algho, le crawler n'atteint jamais la page : depuis le sitemap, il trouve le lien vers/products, mais ne le navigue pas et n'en collecte donc pas les liens. - Si les Adresses à inclure contiennent également
https://exemple.com/products, le crawler navigue/products, collecte le lien vers/products/alghoet la page devient disponible pour l'extraction.
Vous pouvez également saisir exemple.com/products ou exemple.com/products/algho directement dans les Pages supplémentaires de la section Général, en pensant à les ajouter aussi aux Adresses à inclure.
Activez l'option Exclure les sites hors domaine pour limiter la navigation aux seuls liens internes au domaine principal.
Activez l'option Inclure les documents PDF, doc, docx pour naviguer également dans les documents attachés aux pages web.
Dans le champ Adresses à inclure, saisissez la liste des pages du site à naviguer.
Dans le champ Adresses à exclure, saisissez la liste des pages du site à ne pas naviguer.
Les deux champs acceptent des expressions régulières (regex) pour définir des modèles d'URL. Avant de créer des regex, il est utile d'analyser la structure des paths du site : les segments de path révèlent la catégorisation des pages.
Exemple — structure d'un site :
exemple.com/use-cases
exemple.com/products/algho
exemple.com/products/sda
exemple.com/products/booking
exemple.com/products/pricing
exemple.com/blog/first-post
exemple.com/docs/getting-started
exemple.com/docs/getting-started-api
exemple.com/about
exemple.com/contact
Types de modèles principaux :
| Modèle | Exemple | URLs correspondantes |
|---|---|---|
| Correspondance exacte | https://exemple.com/use-cases | https://exemple.com/use-cases |
| Alternance | https://exemple.com/products/((algho)|(sda)|(booking)) | exemple.com/products/algho, exemple.com/products/sda, exemple.com/products/booking |
Caractère générique .* | https://exemple.com/products/.* | exemple.com/products/algho, exemple.com/products/sda, exemple.com/products/booking, exemple.com/products/pricing |
| Préfixe partagé | https://exemple.com/docs/getting-.* | exemple.com/docs/getting-started, exemple.com/docs/getting-started-api |
La structure de chaque regex suit le schéma : https://[domaine]/[segment1]/[segment2]/...
| Composant | Signification |
|---|---|
https:// | Protocole HTTP ou HTTPS |
domaine | Nom de domaine |
.* | Tout texte (caractère générique) |
(a|b|c) | Alternance : l'un parmi a, b ou c |
Une regex doit être testée sur l'ensemble des URLs du site, pas uniquement sur les pages connues. Cela révèle les faux positifs : pages non désirées que la regex capture quand même.
Par exemple, https://exemple.com/products/.* capture à la fois products/algho (désiré) et products/pricing (faux positif). Si pricing n'est pas désiré, le modèle avec alternance est préférable.
Principes pour choisir la meilleure regex :
- Préférer la simplicité : une regex courte et lisible est préférable à une complexe.
- Toujours tester sur l'ensemble du crawl : une regex qui fonctionne uniquement sur les pages connues n'est pas fiable.
- Éviter les regex trop génériques :
https?://.*capture l'ensemble du site, ce qui n'est pas utile. - Envisager la croissance future : un caractère générique sur une catégorie capturera également les pages ajoutées après la définition de la règle.
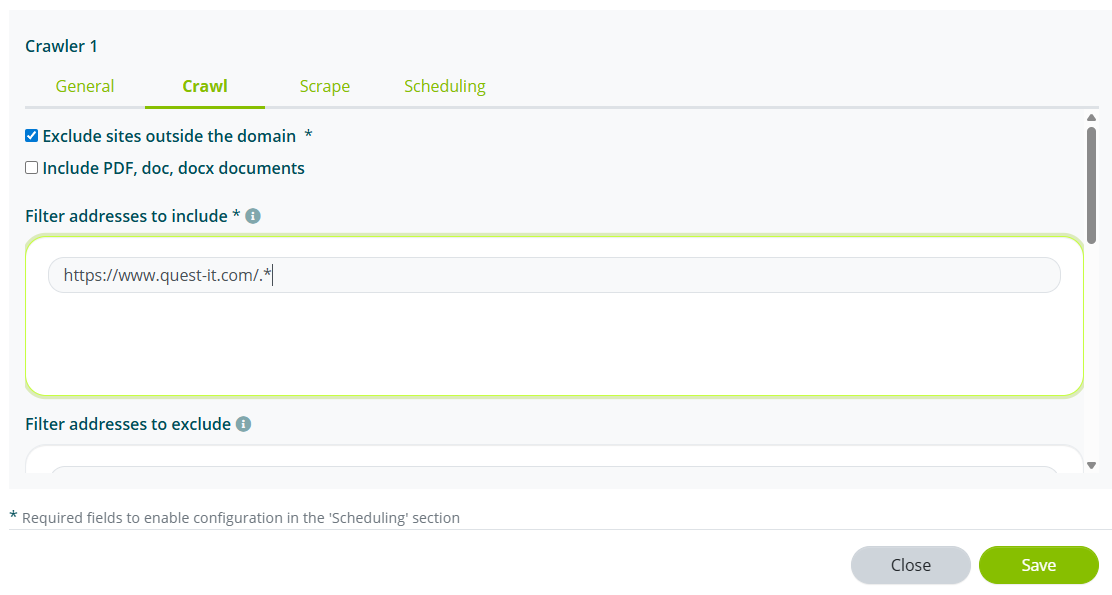
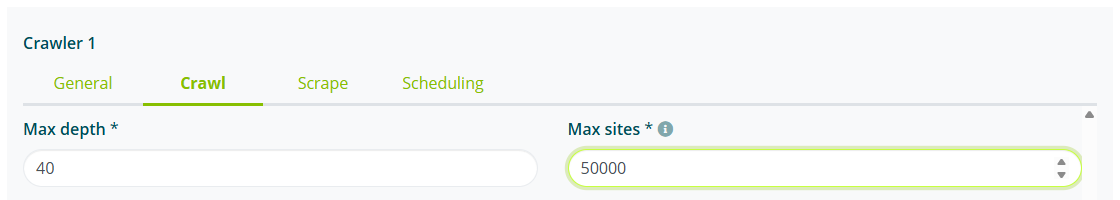
Définissez la profondeur maximale et le nombre maximum de pages à naviguer.
Extraction
Dans la section Extraction, vous configurez les règles que le Crawler suivra pour transformer les pages web en documentation.
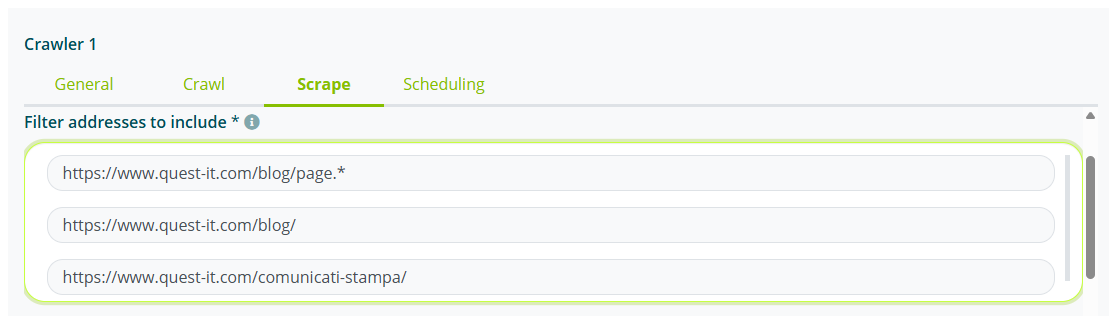
Dans le champ Filtrer les adresses à inclure, saisissez la liste des pages à extraire et à convertir en documentation.
Les deux champs acceptent les mêmes expressions régulières décrites dans la section Navigation. Les pages à extraire peuvent coïncider avec les pages à naviguer ou représenter un sous-ensemble spécifique.
Une page ne peut être extraite que si son URL a été collectée pendant la phase de navigation. Assurez-vous que les Adresses à inclure dans la section Navigation couvrent toutes les pages souhaitées.
Dans le champ Filtrer les adresses à exclure, saisissez la liste des pages à ne pas extraire.
Supprimer des éléments de la page
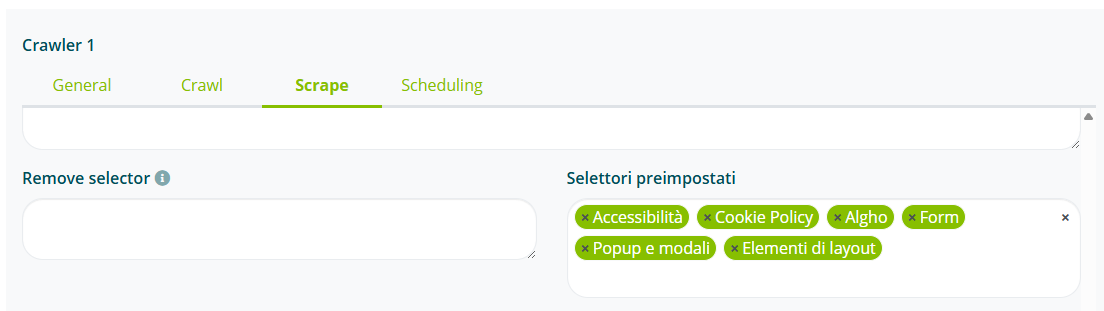
Avant de convertir une page en PDF, le crawler effectue déjà un nettoyage de base du contenu. Cependant, chaque site est structuré différemment et peut contenir des éléments inutiles pour la documentation, comme des menus, des bannières, des pieds de page ou des bandeaux de cookies. Le champ Supprimer les éléments permet un nettoyage plus précis : les éléments indiqués sont supprimés de la page avant la génération du PDF.
Le champ propose quelques sélecteurs prédéfinis et accepte également des sélecteurs saisis manuellement, au format CSS, XPATH ou compatible avec Puppeteer.
Les sélecteurs CSS les plus utilisés sont :
| Type | Syntaxe | Exemple | Éléments supprimés |
|---|---|---|---|
| Classe | . + nom de la classe | .cookie-banner | Tous les éléments avec class="cookie-banner" |
| ID | # + id | #newsletter | L'élément avec id="newsletter" |
| Élément HTML | nom de l'élément | header, footer, nav | Tous les éléments de ce type |
Pour identifier les classes et les id à supprimer, ouvrez la page dans le navigateur, faites un clic droit sur l'élément et sélectionnez Inspecter : le code HTML mis en évidence affiche les attributs class et id de l'élément.
Si un élément possède plusieurs classes, il suffit d'en indiquer une seule. Par exemple, pour un menu avec class="sidebar menu-laterale", le sélecteur .menu-laterale suffit.
La suppression s'applique à toutes les pages extraites par le crawler. C'est pourquoi il est conseillé d'indiquer surtout les éléments communs à l'ensemble du site : si un menu latéral identifié par la classe .menu-laterale apparaît sur chaque page, il suffit de saisir le sélecteur une seule fois pour le supprimer partout. Les éléments présents uniquement sur certaines pages doivent en revanche être identifiés et ajoutés individuellement.
Évitez les sélecteurs trop génériques comme div : un élément aussi courant est présent dans presque toute la page et sa suppression éliminerait également le contenu à extraire.
Le crawler effectue déjà un nettoyage préliminaire de la page : saisir manuellement les éléments à supprimer n'est pas obligatoire, mais c'est recommandé surtout pour les sites plus anciens ou aux mises en page particulières.
Planification
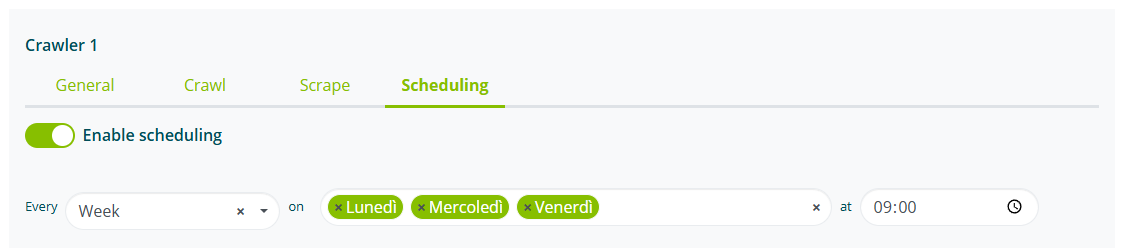
Sélectionnez Activer la planification et définissez la fréquence d'exécution du Crawler (hebdomadaire ou mensuelle), puis configurez le jour et l'heure de démarrage ; vous pouvez définir plusieurs jours de la semaine ou du mois pour une exécution répétée.
Visualisation des documents
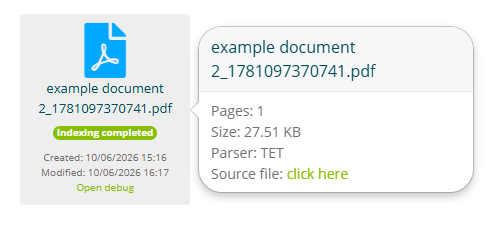
Pour vérifier les documents PDF générés par le crawler, revenez au sous-dossier dans Smart Document Access.
La liste des documents indexés sera disponible dans la section dédiée au sous-dossier configuré.
Chaque document a comme Fichier source l'URL à partir de laquelle il a été généré.